はじめに
こんにちは、株式会社レコチョク NX開発推進部 プロダクト開発第2Gの上野です。
普段はPlayPASS PAK(以下PAK)の開発を担当しています。
先日発表された日本ゲーム大賞2026で、ゲームデザイナーズ大賞を受賞した『文字遊戯』というゲームが気になっています。すべてが文字でできた世界を、文字を消したり動かしたりして進むゲームです。
今回は、そんなモバイルアプリ開発での文字にまつわる体験談をお話しします。
PAKアプリは、Kotlin Multiplatform(以下KMP)で開発しており、AndroidとiOSで処理の一部をKotlinの共通コードにしています。あるとき、プレイリスト名の入力欄のテストをしていました。プレイリスト名は、300文字まで入力できます。上限いっぱいまで入力し、末尾に絵文字を入れて保存するというテストを行いました。保存した後のプレイリスト名を見てみると、iOSで、末尾の絵文字が文字化けしていました。
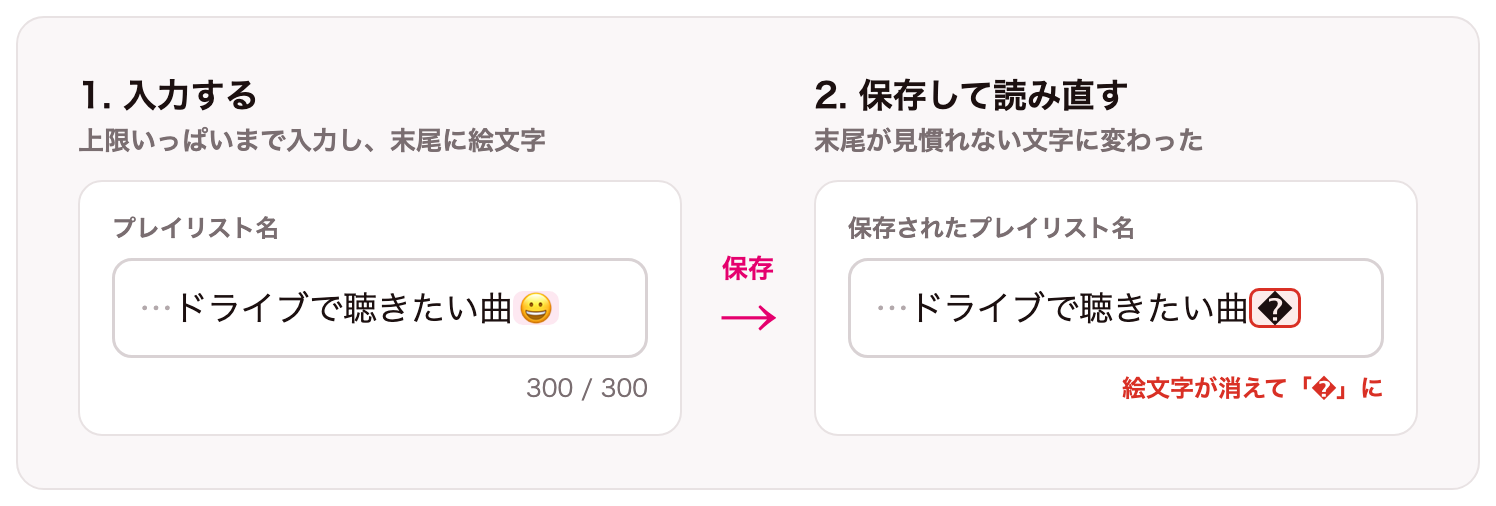 図1. 上限いっぱいまで入力して保存した後、プレイリスト名を見ると末尾の絵文字が「�」に変わっていた。
漢字やひらがなだけなら、上限まで入力しても文字化けせず、絵文字を含めたときだけ起きていました。iOSでは、入力中の画面では絵文字も正しく表示され、カウンタも上限の範囲に収まっていました。一方のAndroidでは、絵文字を入れるとカウンタが300へ届く前に入力が止まる、という別の症状が出ていました。
変わったのは保存した後なので、まず保存処理のコードを確認しました。保存処理はAndroidとiOSの共通コードで、このような処理になっていました。
// commonMain: プレイリストを端末内のデータベースへ保存する
class PlaylistRepositoryImpl(
    private val dao: PlaylistDao,
    private val idGenerator: PlaylistIdGenerator,
    private val now: () -> Long,
) : PlaylistRepository {

    override suspend fun savePlaylist(draft: PlaylistDraft): Result
<String> {
        val playlistId = idGenerator.newPlaylistId()
        val title = resolveTitle(draft)  // 保存するプレイリスト名を決める
        val entity = PlaylistEntity(
            playlistId = playlistId,
            title = title,
            updatedAt = now(),
        )
        val items = draft.items.map { /* 楽曲をデータベース用の形に変換(省略) */ }
        dao.insertPlaylistWithItems(entity, items)
        return Result.Success(playlistId)
    }

    // 入力欄の上限はOSごとの実装なので、漏れに備えて保存の直前にも切り詰める
    private fun resolveTitle(draft: PlaylistDraft): String {
        return draft.title.take(PLAYLIST_TITLE_MAX_LENGTH)  // 上限は300文字
    }
}
このうち、プレイリスト名に関わるのは、保存の直前に上限で切り詰める次の部分です。
private fun resolveTitle(draft: PlaylistDraft): String {
    return draft.title.take(PLAYLIST_TITLE_MAX_LENGTH)  // 上限は300文字
}takeは、先頭から指定した数だけ文字を取り出す関数です。文字列が指定した数より短くても例外にならないため、切り詰める処理に合っています。
特に問題はなさそうなのに、なぜ文字化けしたのか。そして、なぜiOSとAndroidで症状が違ったのか。今回は、この2つの疑問を順に解きながら、人間とコンピュータで文字の数え方がどう違うのかを解説します。
想定読者
- 文字列の長さを数えたり切り詰めたりする処理を書く人
- 入力欄の文字数の上限やカウンタを実装する人
- 絵文字を含む文字列で、文字数のずれや文字化けに困ったことがある人
動作環境
- Kotlin 2.3.0(KMP)
- Xcode 26.3
- iOS:iPhone 17 シミュレータ(iOS 26.3.1)
- Android:Pixel 10(Android 16)
疑問1:なぜ文字化けしたのか
文字化けは、絵文字を含めたときだけ起きていました。そして保存の直前には、takeで300文字に切り詰めています。そこでまずは、絵文字がコンピュータの中でどう数えられているのかを調べていきます。
人が数える1文字
私たちは文字を「見た目のまとまり」で数えています。「あ」や😀は、1つの塊に見えるので1文字です。
この「人が1文字と感じるまとまり」に近い区切り方を、Unicodeでは書記素クラスタ(grapheme cluster)と呼びます。
コンピュータが扱う2つの単位
一方、コンピュータはこの書記素クラスタをさらに分解した形で文字を持っています。分解していくと、コードポイントとコードユニットという2つの単位が出てきます。
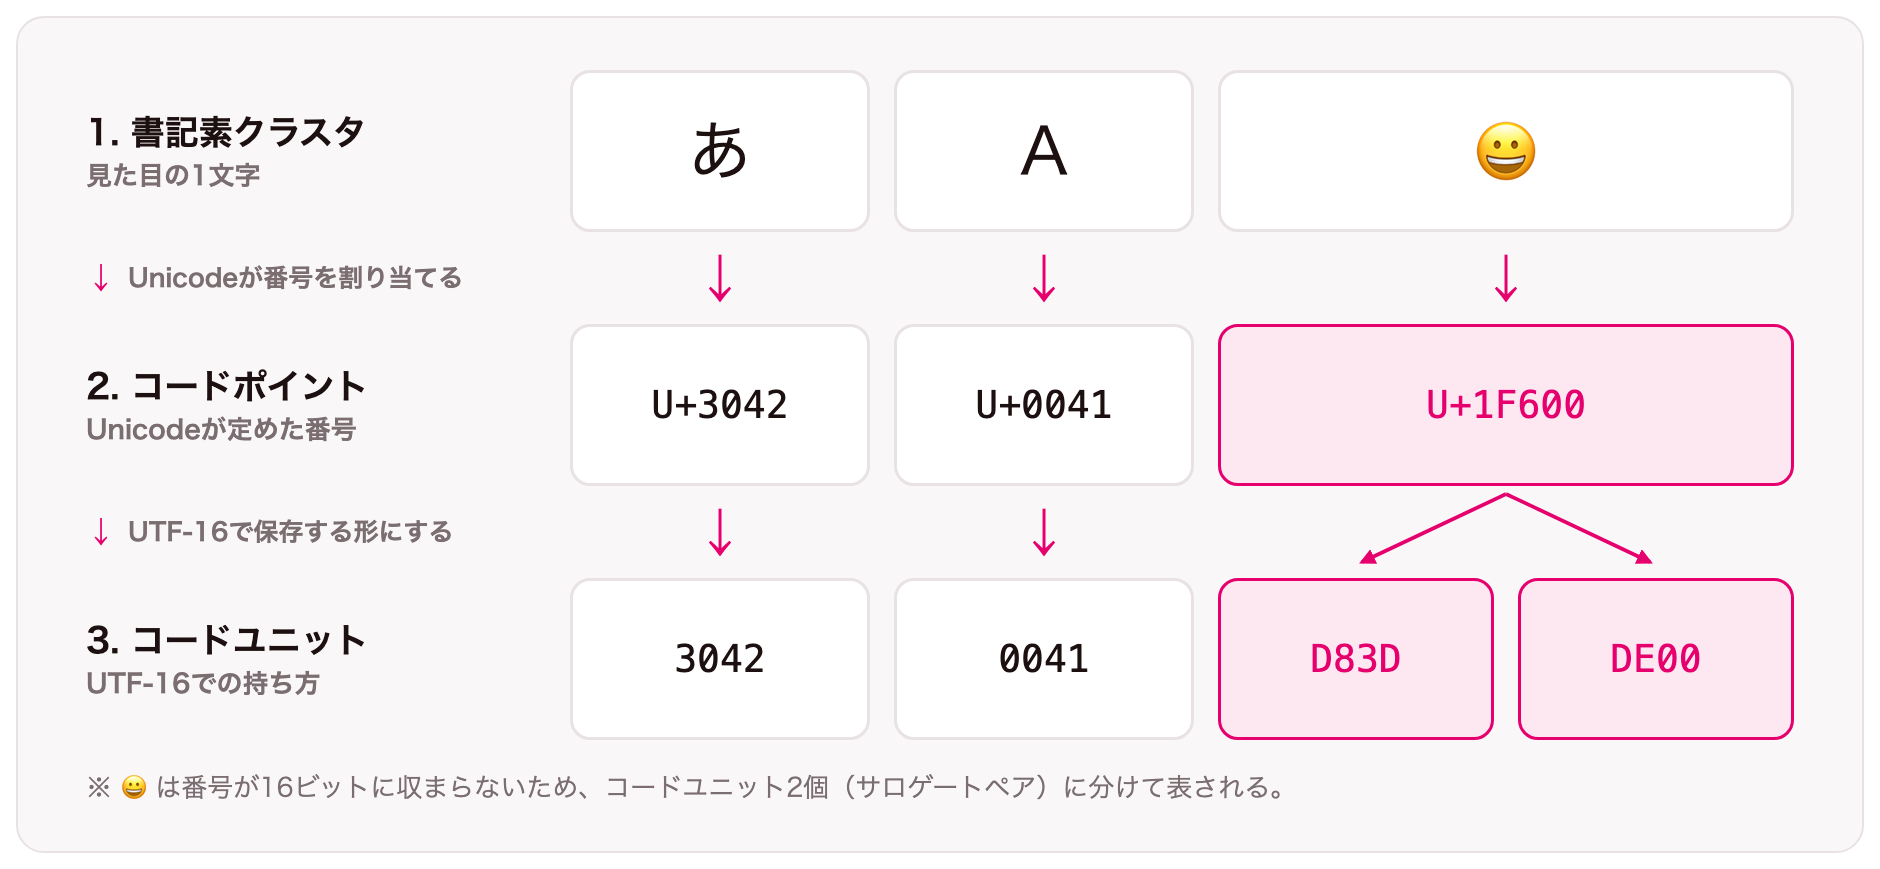 図2. 書記素クラスタを、コードポイントとコードユニットに分解する。
コードポイントは、Unicodeが文字に与えた番号です。「あ」ならU+3042、😀ならU+1F600。文字の戸籍番号のようなもので、世界中の文字に1つずつ割り当てられています。
コードユニットは、その番号をメモリやファイルへ保存するとき、実際に並ぶ数値の単位です。1単位の大きさは保存の方式(符号化方式)によって違い、UTF-8なら8ビット、UTF-16なら16ビットです。Kotlinの文字列は中身がUTF-16で、lengthやtakeもその単位を数えます。そのため、この記事ではUTF-16を前提に話を進めます。
ひらがなやアルファベットは、分解してもコードポイントで1つ、コードユニットでも1つのままです。「あ」はU+3042を、そのまま3042という1単位で持てます。
一方の😀は、コードポイントまでは1つですが、コードユニットになると2つに分かれます。番号のU+1F600が16ビットに収まらないため、D83DとDE00の2単位に分けて持つからです。このように、1つの番号を2つのコードユニットで表す仕組みをサロゲートペアと呼びます。絵文字の多くは16ビットに収まらない番号を持っているので、ほとんどの絵文字はUTF-16で見ると最初から2単位です。
複数の絵文字を組み合わせる仕組み
分かれるのはコードユニットだけではありません。😀のようなシンプルな絵文字であれば、コードポイントは1つで済みます。しかし、肌の色・性別・家族構成・国旗のようにバリエーションを持つ絵文字では、コードポイントさえ複数を組み合わせて使います。組み合わせの数が多すぎて、1つずつ番号を振りきれないためです。家族構成を表す👨👩👧👦も、その1つです。このように、複数の部品を並べて1つの文字に見せる仕組みを、ここでは「合成」と呼びます。
合成の代表的な仕組みがZWJ(ゼロ幅接合子、U+200D)です。ZWJは前後の絵文字をつなげて1つに見せるための、幅を持たない見えない文字です。役割としては単語をつなぐハイフンに近く、👨・👩・👧・👦をZWJで3箇所つなぐと、あの家族の絵文字になります。分解すると図3のとおりです。
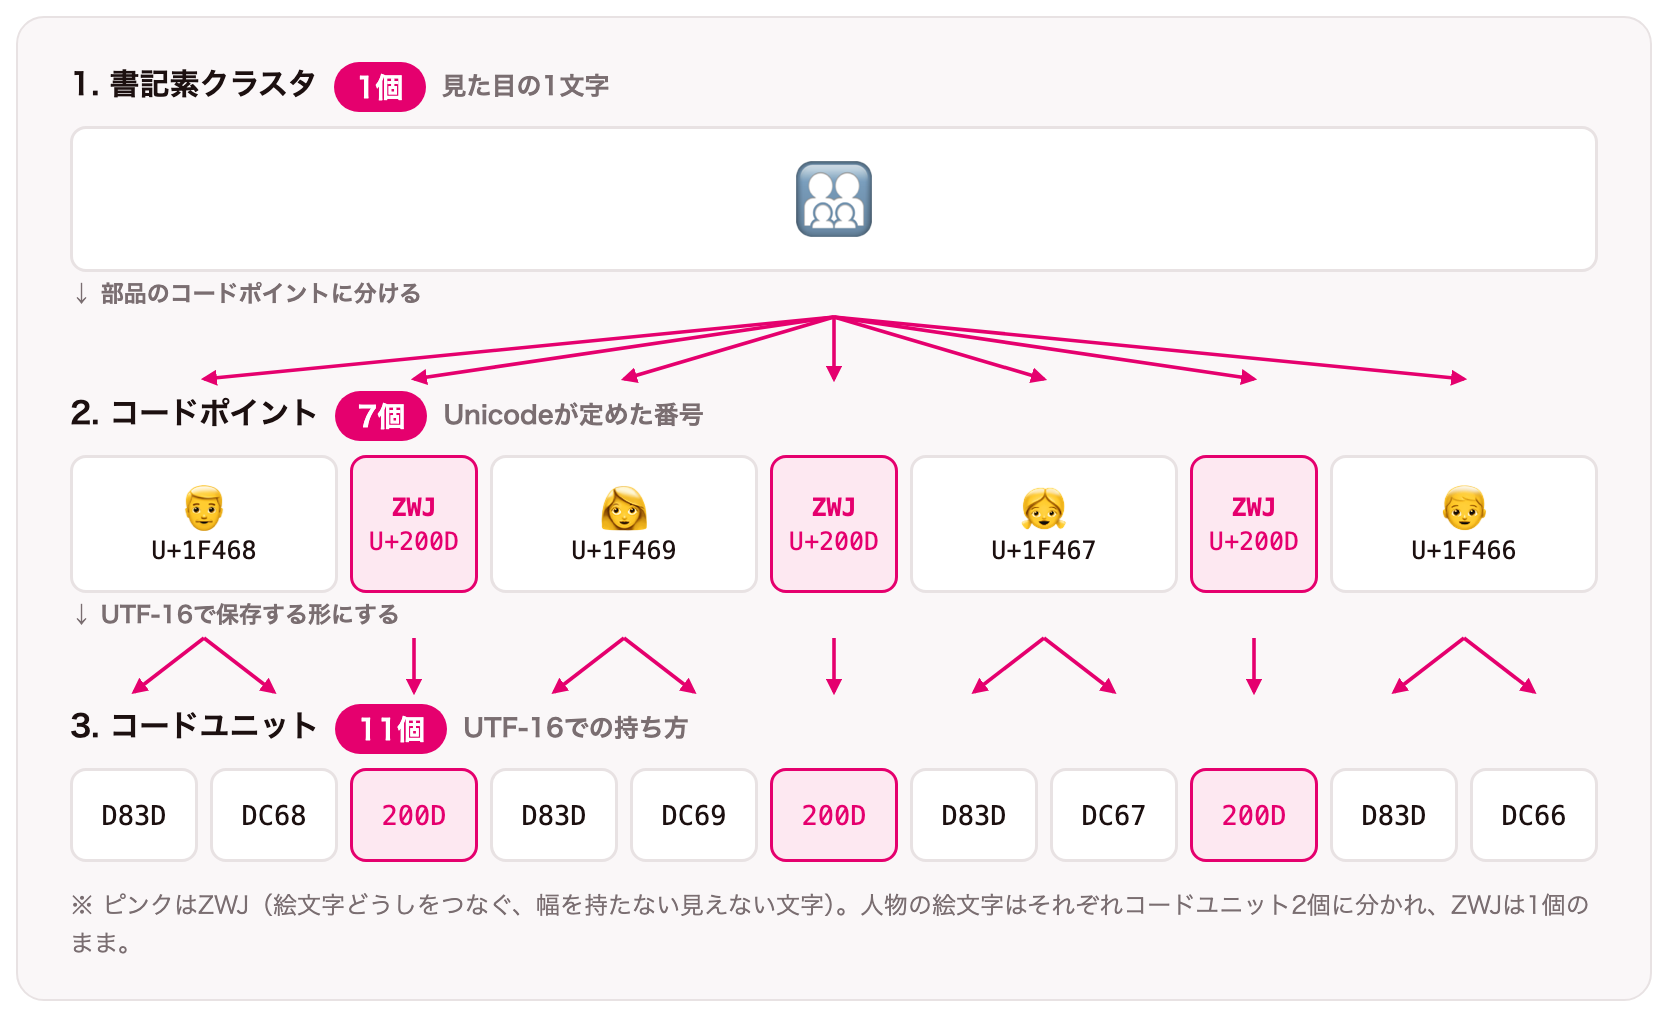 図3. 👨👩👧👦を3つのレベルで分解した図。
人物絵文字4個はそれぞれサロゲートペアで2ユニット、間のZWJが3個で、合わせて11。見た目の1文字の裏には、11個のコードユニットが並んでいるわけです。
3つの単位で数え比べる
ここまでに出てきた文字を、3つの単位でそれぞれ数えると次のようになります。
| 文字 | 書記素クラスタ | コードポイント | コードユニット(UTF-16) |
|---|---|---|---|
| A | 1個 | 1個 | 1個 |
| あ | 1個 | 1個 | 1個 |
| 😀 | 1個 | 1個 | 2個 |
| 👨👩👧👦 | 1個 | 7個 | 11個 |
文字としては1文字に見えるものも、単位を深掘りすると複数になる可能性があると分かりました。😀のような絵文字1つでも、UTF-16のコードユニットで見ると2つに分かれています。たとえば文字数の上限で切り詰めるときに、この2つの間で切れてしまうと、サロゲートペアの前半だけが残ります。半分だけでは文字として成立しません。それが冒頭の「�」の正体ではないか、と考えられます。
もし、ある処理は見た目の1文字で数え、別の処理はコードユニットで切っていたら、この切れ方が起きます。文字数を扱う処理は、扱う文字に適した単位ですべてそろえる必要があります。こうした処理どうしの整合性を欠くと、同じ文字列でも処理によって長さの解釈が変わってしまいます。
疑問2:なぜiOSとAndroidで症状が違ったのか
では、PAKのプレイリスト名は、この整合性が取れていたのでしょうか。ここからは2つ目の疑問、なぜiOSとAndroidで症状が違ったのか、を確かめます。
プレイリスト名は、入力されてから保存されるまでに、文字数を扱う次の3つの処理を通ります。
- カウンタ:入力中の文字数を「12 / 300」のように画面に出す
- 入力の上限:300文字を超える入力を止める
- 保存の切り詰め:入力側の制御漏れに備えて、保存の直前に300文字で切り詰める
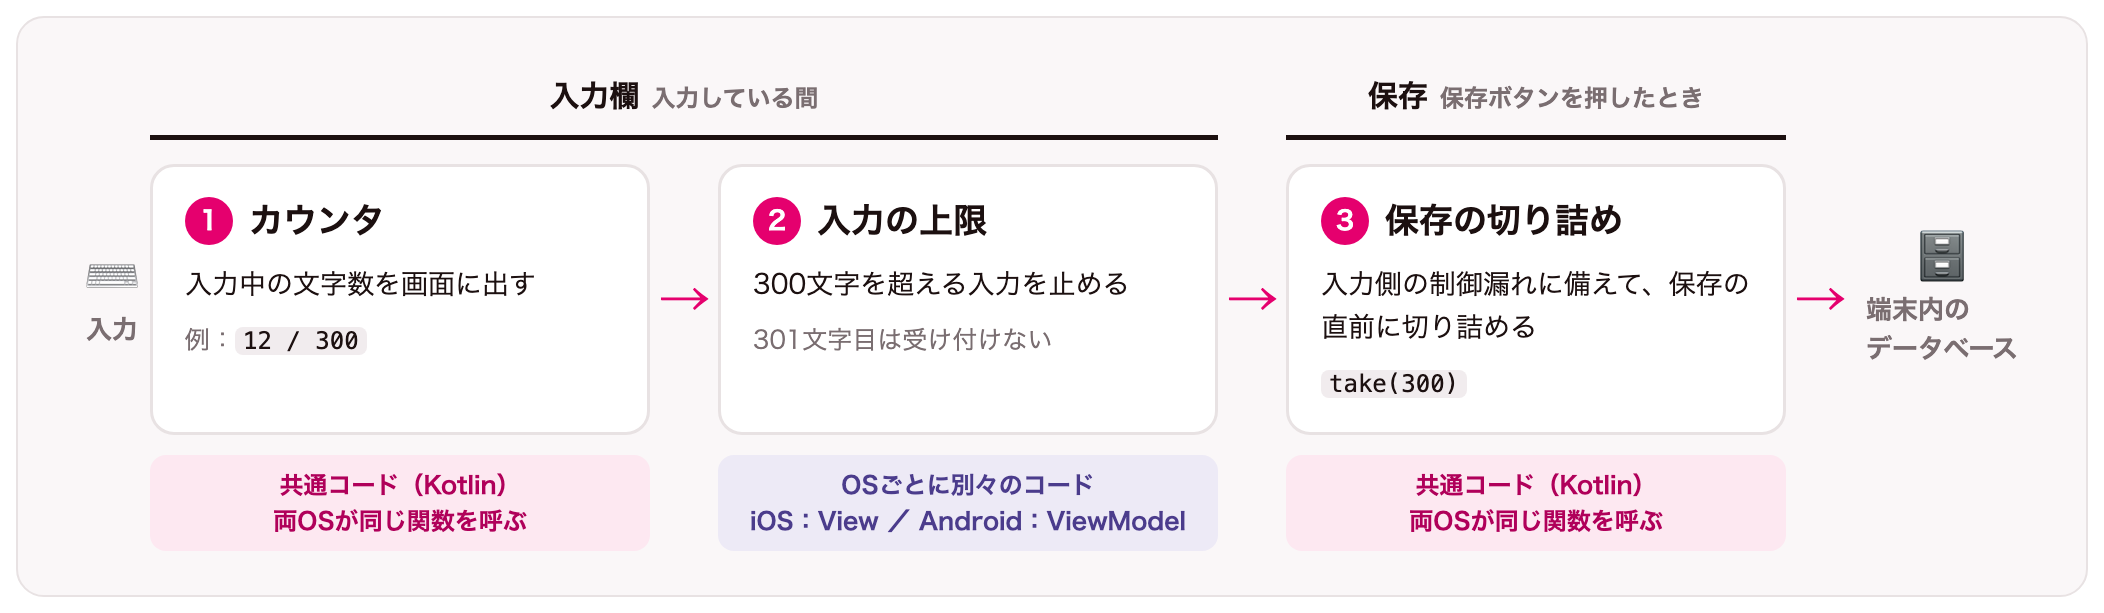 図4. プレイリスト名の文字数を扱う3つの処理。カウンタと保存の切り詰めは共通コード、入力の上限はOSごとに書いている。
それぞれが、どの単位で数えていたかを順に見ていきます。
カウンタの数え方(共通コード)
プレイリスト名の入力欄には、「12 / 300」のような文字数カウンタが付いています。カウンタに出す数は、PAKで用意した次の関数で数えています。
// commonMain: 宣言だけを共通コードに置き、両OSがこの関数を呼ぶ
expect fun countGraphemes(text: String): Int
// androidMain: Android向けの中身
private val GRAPHEME = Pattern.compile("\\X")
actual fun countGraphemes(text: String): Int {
if (text.isEmpty()) return 0
val m = GRAPHEME.matcher(text)
var count = 0
while (m.find()) count++ // マッチ1回 = 書記素クラスタ1個
return count // 👨👩👧👦 → 1
}KMPの共通コードで使えるKotlinの標準ライブラリには、書記素クラスタで数える関数がありません。そこでPAKでは、countGraphemesという関数を用意し、宣言だけを共通コードに置いて、中身はOSごとに書いています。カウンタは、AndroidとiOSのどちらもこの同じ関数を呼んで数えています。
上のコードはAndroid向けの中身で、Javaの正規表現の\Xを使っています。\Xは、書記素クラスタ1個にマッチします。この関数はそのマッチ回数を返すので、見た目の1文字、つまり書記素クラスタで数えていることになります。iOS向けの中身は書き方が違いますが、同じく書記素クラスタで数えます。
カウンタは👨👩👧👦を1文字と数えます。カウンタの数え方は、両OSとも人間の数え方にそろっていました。
入力の上限の判定(OSごとのコード)
次は、300文字を超える入力を止める処理です。この処理は共通コードではなく、iOSはView、AndroidはViewModelと、OSごとに別々に書いていました。PAKでは、画面を表示するViewと、画面の状態を持つViewModelはOSごとに書き、画面に出す値の計算やデータの保存は共通コードに置いています。キー入力を受けて止める処理は画面側の仕事なので、OSごとの実装になっていました。
iOSでは、入力欄のUITextViewが文字を受け付ける直前に、変更後の文字列をカウンタと同じ関数で数えて判定していました。
// iosApp: 変更後の文字数が上限を超えるなら、入力を受け付けない
func textView(_ textView: UITextView, shouldChangeTextIn range: NSRange, replacementText text: String) -> Bool {
    let proposed = (textView.text as NSString).replacingCharacters(in: range, with: text)
    // countGraphemes は、カウンタと同じ共通コードの関数(Swift の count ではない)
    let length = Int(PlaylistTitleLength_iosKt.countGraphemes(text: proposed))
    return length <= Int(PlaylistConstants.shared.PLAYLIST_TITLE_MAX_LENGTH)
}一方のAndroidでは、入力された文字列をViewModelで受け取り、Kotlinのlengthで判定して、substringで切り詰めていました。
// androidApp: ViewModel で、上限を超えていたら切り詰める
fun setTitle(title: String) {
    val trimmed = if (title.length > PLAYLIST_TITLE_MAX_LENGTH) {  // コードユニットで判定
        title.substring(0, PLAYLIST_TITLE_MAX_LENGTH)              // コードユニットで切る
    } else {
        title
    }
    // 下書きのプレイリスト名を trimmed で更新する(省略)
}同じ「300文字まで」でも、iOSは書記素クラスタ、Androidはコードユニットで判定していたことになります。iOSは、入力の上限もカウンタと同じ関数を使って判定するよう対応できていましたが、Androidはこの対応が抜けていました。そのためAndroidでは、絵文字が2文字以上と数えられ、カウンタが300へ届く前に入力が止まっていました。また、substringもコードユニットで切るため、冒頭のように上限の手前で絵文字を入れると、絵文字は入りきらず、前半のコードユニットだけが文字列に残ります。
保存の切り詰め(共通コード)
最後に、保存するときはどうでしょうか。冒頭で紹介した保存のコードでは、次の1行でプレイリスト名を切り詰めていました。
// 冒頭の resolveTitle の return 文
return draft.title.take(PLAYLIST_TITLE_MAX_LENGTH)保存の直前に使っていたtakeも、Androidの入力の上限のsubstringと同じく、コードユニット単位で切ります。公式ドキュメントでは「先頭からn文字を返す」と説明されていますが、ここでいう1文字はKotlinのCharのことです。CharはUTF-16のコードユニット1個を表すので、絵文字はChar2つ(サロゲートペア)で表されます。
iOSでは、入力欄に見た目で300文字まで入ります。絵文字が含まれていれば、そのときのCharの数は300を超えます。そのため、300個目のCharがちょうど絵文字の途中に当たると、サロゲートペアの前半だけが残った文字列ができあがります(図5)。
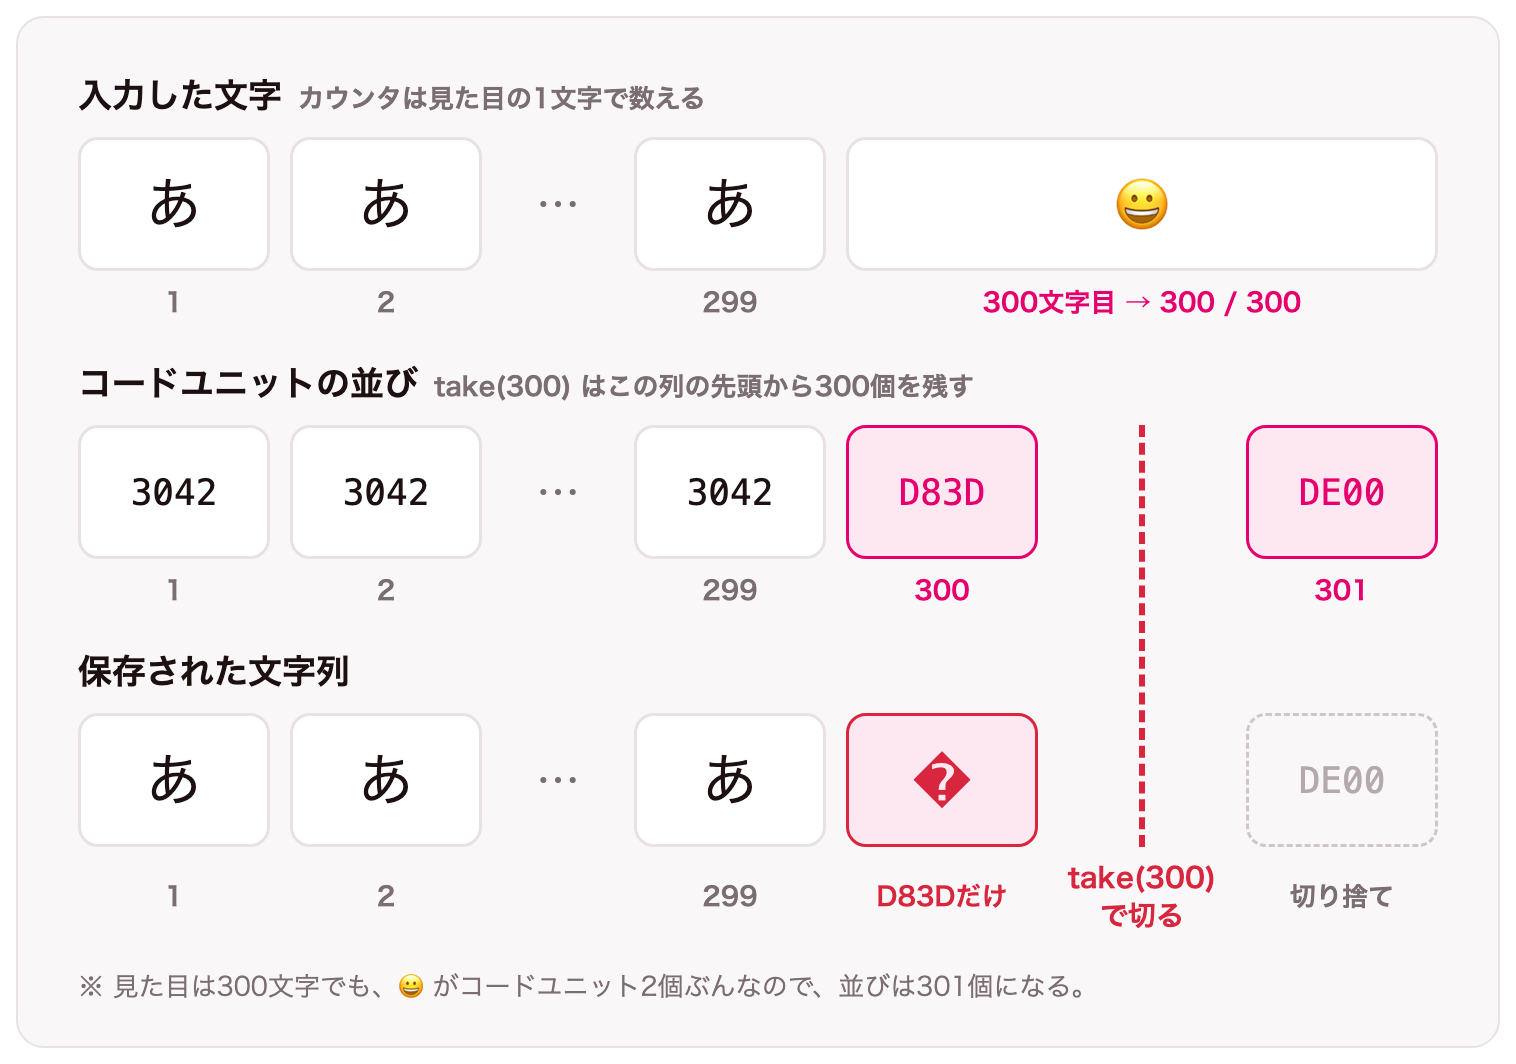 図5. 299文字の後ろに😀を入れて保存すると、take(300)が😀の途中で切り、前半のD83Dだけが残る。
前半だけでは文字として成立しません。PAKが使っているRoomは、文字列をUTF-16のまま端末内のデータベース(SQLite)へ渡します。SQLiteは文字列をUTF-8で持つため、保存するときにはUTF-16からUTF-8へ、読み出すときにはUTF-8からUTF-16へ、SQLite自身が変換します。読み出すときのこの変換で、文字として成立しない部分は「�」(U+FFFD、置換文字)という代わりの記号に置き換えられます。これが、冒頭の「�」の正体でした。1つ目の疑問で見た、サロゲートペアの前半だけが残る現象が、実際に起きていたことになります。
3つの処理を並べてみる
ここまでの3つの処理を、OSごとに並べると次のようになります。
| 処理 | Android | iOS |
|---|---|---|
| カウンタ | 書記素クラスタ | 書記素クラスタ |
| 入力の上限 | コードユニット | 書記素クラスタ |
| 保存の切り詰め | コードユニット | コードユニット |
iOSでは、入力欄は書記素クラスタ、保存はコードユニットと、入力欄と保存とで数える単位が違っていたのです。
そのため、見た目で300文字の文字列がそのまま保存処理に届き、takeが絵文字の途中で切っていました。冒頭のiOSの文字化けは、このためです。Androidは、入力の時点でコードユニット単位に切り詰めていたため、300を超える文字列は保存処理まで届きません。ただし、切れ目が絵文字の途中に当たれば、入力の時点で同じように割れます。
もともとは、3つの処理ともコードユニットで数えていました。そこからカウンタを書記素クラスタに変え、その後iOSの入力の上限もカウンタにそろえました。一方、Androidの入力の上限と保存の切り詰めは、コードユニットのまま残っていました。特に保存の直前の切り詰めはロジックの奥にあり、画面からは見えません。カウンタや入力欄を直したときにも考慮されず、そのまま残っていたのです。
単位をそろえる
では、どう直せばよいでしょうか。ユーザーに見せる上限は、見た目の文字数であるべきです。それに、書記素クラスタは、途中で切っても文字が壊れない唯一の単位でもあります。コードユニットで切ればサロゲートペアが割れて「�」になり、コードポイントで切っても👨👩👧👦が👨👩になるなど、見た目が変わってしまいます。そこで、コードユニットのまま残っていたAndroidの入力の上限と保存の切り詰めを、書記素クラスタにそろえます。
countGraphemesの隣に「書記素クラスタ単位で切る」関数を追加し、lengthとsubstring、takeを置き換えました。
// commonMain: 「切る」も宣言を共有する
expect fun clampToGraphemes(text: String, limit: Int): String

// androidMain: \X の境界(Matcher.end)を limit 個目まで進めて切る
actual fun clampToGraphemes(text: String, limit: Int): String {
    val m = GRAPHEME.matcher(text)
    var count = 0
    var end = 0
    while (m.find()) {
        count++
        end = m.end()
        if (count >= limit) break
    }
    return text.substring(0, end)  // 書記素クラスタの途中では切れない
}

// 保存:resolveTitle の return 文
return clampToGraphemes(draft.title, PLAYLIST_TITLE_MAX_LENGTH)

// Androidの入力の上限:setTitle の判定と切り詰め
val trimmed = clampToGraphemes(title, PLAYLIST_TITLE_MAX_LENGTH)
直す前と直した後の3つの処理を比べると、次のとおりです。
| 処理 | 直す前(Android / iOS) | 直した後(両OS) |
|---|---|---|
| カウンタ | 書記素クラスタ / 書記素クラスタ | 書記素クラスタ |
| 入力の上限 | コードユニット / 書記素クラスタ | 書記素クラスタ |
| 保存の切り詰め | コードユニット / コードユニット | 書記素クラスタ |
これで、3つの処理はどれも書記素クラスタで数えるようになりました。
- カウンタ:
countGraphemesで数える(両OS) - 入力の上限:iOSは
countGraphemesで数えて止め、AndroidはclampToGraphemesで切り詰める - 保存の切り詰め:
clampToGraphemesで切る(両OS)
数える関数と切る関数は共通コードの1箇所に置き、3つの処理はどれもそこを呼ぶ形にしています。どこか1箇所にでも素のlengthやtakeが残っていれば、また同じずれが起きるためです。
まとめ
😀は、人間が数えれば1文字ですが、Kotlinのlengthやtakeで数えると2文字です。今回の文字化けは、この「1文字」の単位を取り違えたことで起きました。
- 同じ1文字でも、書記素クラスタ・コードポイント・コードユニットのどれで数えるかによって個数が変わる
- 文字数を扱う処理(数える・入力を止める・切る)は、すべて同じ単位でそろえる。ユーザーに見せる文字数なら、書記素クラスタにする
- 数える関数と切る関数は共通コードの1箇所に置き、どの処理からも同じ関数を呼ぶ
おわりに
今回取り上げたのは一例で、入力欄での絵文字の扱いにはほかにも苦戦しました。SwiftとKotlinでデフォルトの文字列の仕様が違うことや、日本語入力で変換中の文字をどう扱うかなどです。AndroidとiOSで共通の処理を持つKMPならではの難しさを感じました。
一方で、普段はあまり意識しない文字コードの仕様までたどったことで、Unicodeや文字列の処理への理解を深められました。
最後まで読んでいただきありがとうございました。
参考文献
上野 翔碁